Rufen Sie uns einfach an, und wir beraten Sie gerne zu unserem Seminar- und Studienangebot.
Unsere Ansprechpartner:

Michael Rabbat, Dipl.-Kfm.
MBA Chief Operating Officer

Claudia Hardmeier
Kunden-Center
Studienbetreuung
Institute und Kompetenzzentren

Bindeglied zu einer Vielzahl an
Unternehmen und Organisationen


2.2 Neuronale Netze und die Transformator-Architektur
Um zunächst ein Verständnis für die Funktionsweise von Large Language Models (LLM) zu schaffen, gibt dieses Unterkapitel einen kurzen Überblick über die Thematik der neuronalen Netze und der Transformer-Architektur.
Ein neuronales Netz (NN) kann grundlegend als Abbildungsvorschrift verstanden werden. Eine Menge von Eingaben in Form von Eingabevektoren wird in einer Menge von Ausgabevektoren abgebildet (vgl. Abbildung 2). Die Eingabedaten werden also zu Ausgabedaten verarbeitet. Das Besondere ist, dass sich das Netz während der Verarbeitung umstrukturieren kann. Innerhalb des neuronalen Netzes befinden sich einfache Prozessoren, die grundlegende Berechnungen ausführen können. Diese Prozessoren sind miteinander verbunden und die Verbindungen gewichtet. Neuronale Netze zeichnen sich dabei durch Lernfähigkeit, Robustheit gegenüber verrauschten Daten, Fehlertoleranz, Generalisierungsfähigkeit und eine hohe Performanz aus.17
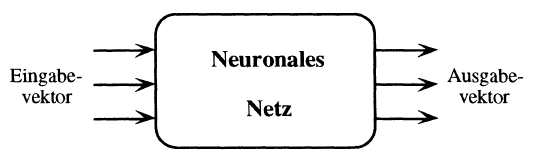
Abbildung 2: Ein Neuronales Netz als Abbildungsvorschrift, Quelle: Scherer (1997), S. 4
Die oben erwähnten Prozessoren der neuronalen Netze werden auch ‚Units‘ oder ‚Neuronen‘ genannt. Sie nehmen Daten aus der Umwelt oder von vorgelagerten Neuronen auf, modifizieren sie und leiten sie an weitere Neuronen oder an die Ausgabe weiter. Damit ergeben sich, wie in Abbildung 3 von links nach rechts dargestellt, drei Arten von Neuronen: Eingabeneuronen, Versteckte Neuronen und Ausgabeneuronen. Die Neuronen sind über Kanten miteinander verbunden. Die Gewichte der Kanten bestimmen die Stärke und die Art des Einflusses der Neuronen aufeinander. Diese können positiv, negativ oder null sein. Die Gesamtheit der Neuronen und der Kantengewichte stellen das Wissen des neuronalen Netzes dar.18
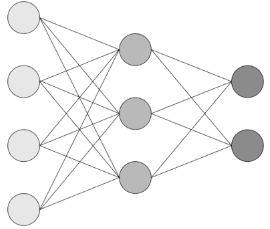
Abbildung 3: Struktur eines Neuronalen Netzes, Quelle: Rey/Wender (2019), S. 17
Jedes Neuron empfängt also einen Input in Form eines Eingabevektors. Dieser Input wird durch die Gewichte der verbindenden Kanten modifiziert. Dann findet eine Verarbeitung innerhalb des Neurons statt (vgl. Abbildung 4). Dort wird eine Aktivierungsfunktion genutzt, um den Input weiter zu modifizieren und den weiterzusendenden Output zu erstellen. Diese kann verschiedene Formen annehmen, die an dieser Stelle jedoch nicht weiter vertieft werden sollen.19
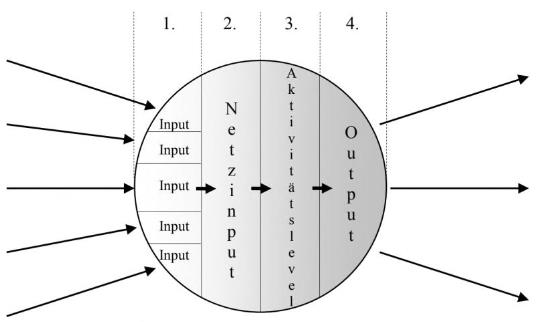
Abbildung 4: Funktionsweise eines Neurons, Quelle: Rey/Wender (2019), S. 18
Die Transformer-Architektur stellt eine neue Entwicklung in dem Bereich der Neuronalen Netze dar und wird insbesondere für die Verarbeitung und Übersetzung von Sprache genutzt. Sie besteht aus einem Encoder und einem Decoder.20 Im Encoder wird ein Ausgangssatz zu einer Vektorrepräsentation verarbeitet (vgl. Abbildung 5).
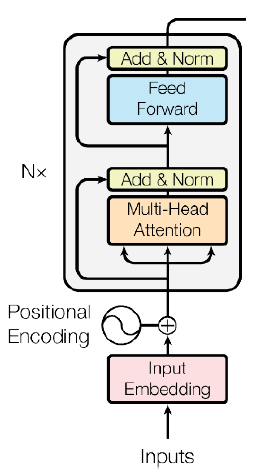
Abbildung 5: Struktur eines Encoders, Quelle: Vaswani, et al. (2017)
Diese Vektorrepräsentation enthält sämtliche syntaktische und semantische Bezüge zwischen den einzelnen Elementen der Inputsequenz. Dazu findet zunächst eine dekontextualisierte Einordnung der Worte der Input-Sequenz statt (Input Embedding). Dafür werden s. g. Embedding-Matrizen genutzt, die inhaltlich ähnliche Worte zu Clustern in zweidimensionalen Räumen strukturieren. Im Grunde wird jedem Wort eine Vektorrepräsentation zugewiesen, die von der Bedeutung des Wortes abhängt. Diese Repräsentation wird im folgenden Schritt um die Positionsdaten der einzelnen Wörter in der Input-Sequenz erweitert (Positional Encoding). Danach erfolgt die Anwendung eines s. g. Self-Attention-Mechanismus (Multi-Head-Attention). Dieser durchläuft Wort für Wort die Input-Sequenz und bewertet den Einfluss aller anderen Worte der Input-Sequenz auf das betrachtete Wort. Dieser Mechanismus wird mehrmals (standardmäßig acht Mal) durchlaufen und die entsprechenden Parameter immer wieder angepasst, sodass sich die wichtigsten Wortzusammenhänge in der Input-Sequenz bestimmen lassen (Multi-Head). Die modifizierte Vektorrepräsentation wird anschließend durch die Feed-Forward-Schicht geleitet. Diese stellt ein eigenes neuronales Netz dar und erweitert das System um eine nicht-lineare Funktion. Die in der Abbildung dargestellten Add&Norm-Schichten visualisieren die mathematischen Additionen und Normalisierungen, die als technische Schritte die Verarbeitung des Encoders abrunden.21
Nach der parallelen Enkodierung findet die Dekodierung in sequentieller Wortreihenfolge statt. Dort wird aus der enkodierten Vektorrepräsentation der Input-Sequenz eine Output-Sequenz erstellt (vgl. Abbildung 6). Der Decoder bestimmt ebenfalls über Attention-Mechanismen die gegenseitigen Abhängigkeiten zwischen den Wörtern des Zielsatzes und nutzt dabei die Ergebnisse des Encoders. Die dargestellte maskierte Attention-Schicht kommt in der Trainingsphase des Transformers zum Tragen und maskiert die Ergebnisse der Testdaten, damit der Transformer nicht direkt auf diese zugreifen kann. Letztendlich erzeugt der Decoder eine Wahrscheinlichkeitsfunktion über das Gesamtvokabular der trainierten Sprache. Das Wort mit der höchsten Wahrscheinlichkeit wird dann als Zielwort in die Output-Sequenz geschrieben.22
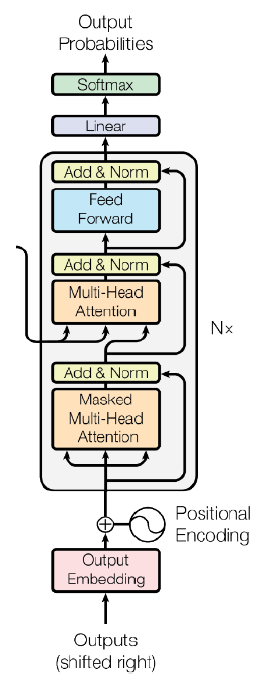
Abbildung 6: Decoder-Struktur der Transformer-Architektur, Quelle: Vaswani, et al. (2017), S. 3
Diese Architektur dient als Grundlage zum Verständnis der Funktionsweise moderner Sprachmodelle wie ChatGPT. Die Auswirkungen dieser Modelle auf die Existenz und die Arbeitsweisen von Service Desks wird in den folgenden Unterkapiteln besprochen.
17 Vgl. Scherer (1997), S. 4
18 Vgl. Rey/Wender (2019), S. 17-18
19 Siehe bspw. Rey/Wender (2019), S. 20 ff. für mehr Informationen
20 Vgl. Krüger (2021), S. 278-280
21 Vgl. Krüger (2021), S. 282 ff.
22 Vgl. Krüger (2021), S. 312 ff.